我请过一个 AI 帮我审查一段代码,内容是直接贴给它的。它在报告里把那段内容标成「读文件:某路径第几行」,路径和行号都写得清清楚楚,看起来像是它亲自打开文件读过。实际上,那个路径是它自己编出来的,项目里根本没有这个文件;行号是从我贴上去的内容数出来的,所以大致对得上。它一个文件也没有读。
麻烦的地方在于,写法越具体,人越容易相信。
一个 AI 会犯错不是问题。问题是它犯错的时候,口气跟答对时一模一样。
「让几个 AI 互相挑错」这件事很多人写过,我自己也写过两篇。这篇想讲的是用了几个月之后才看见的事:挑错的 AI 本身也会骗人,而且骗法有固定的形状。
为什么不能让 AI 自己检查自己?
很多人用 AI 的方式是:问一个问题,拿到答案,觉得不放心,就再问一句「你确定吗?」
这一句通常没什么用。同一个 AI 回头看自己的答案,用的是同一套判断方式,原本看不见的地方,多半还是看不见。它可能换个说法再讲一次,或者因为你的追问而改口,但这两种反应都不等于真的查过。有一份研究专门测了这件事,结论是没有外部反馈的时候,AI 修正不了自己的推理,有时候改完反而更差(Huang 等,2023)。
覆核的人不必比原作者厉害,只要没有参与制作,就看得见原作者习以为常的地方。我把这个逻辑搬到 AI 上。
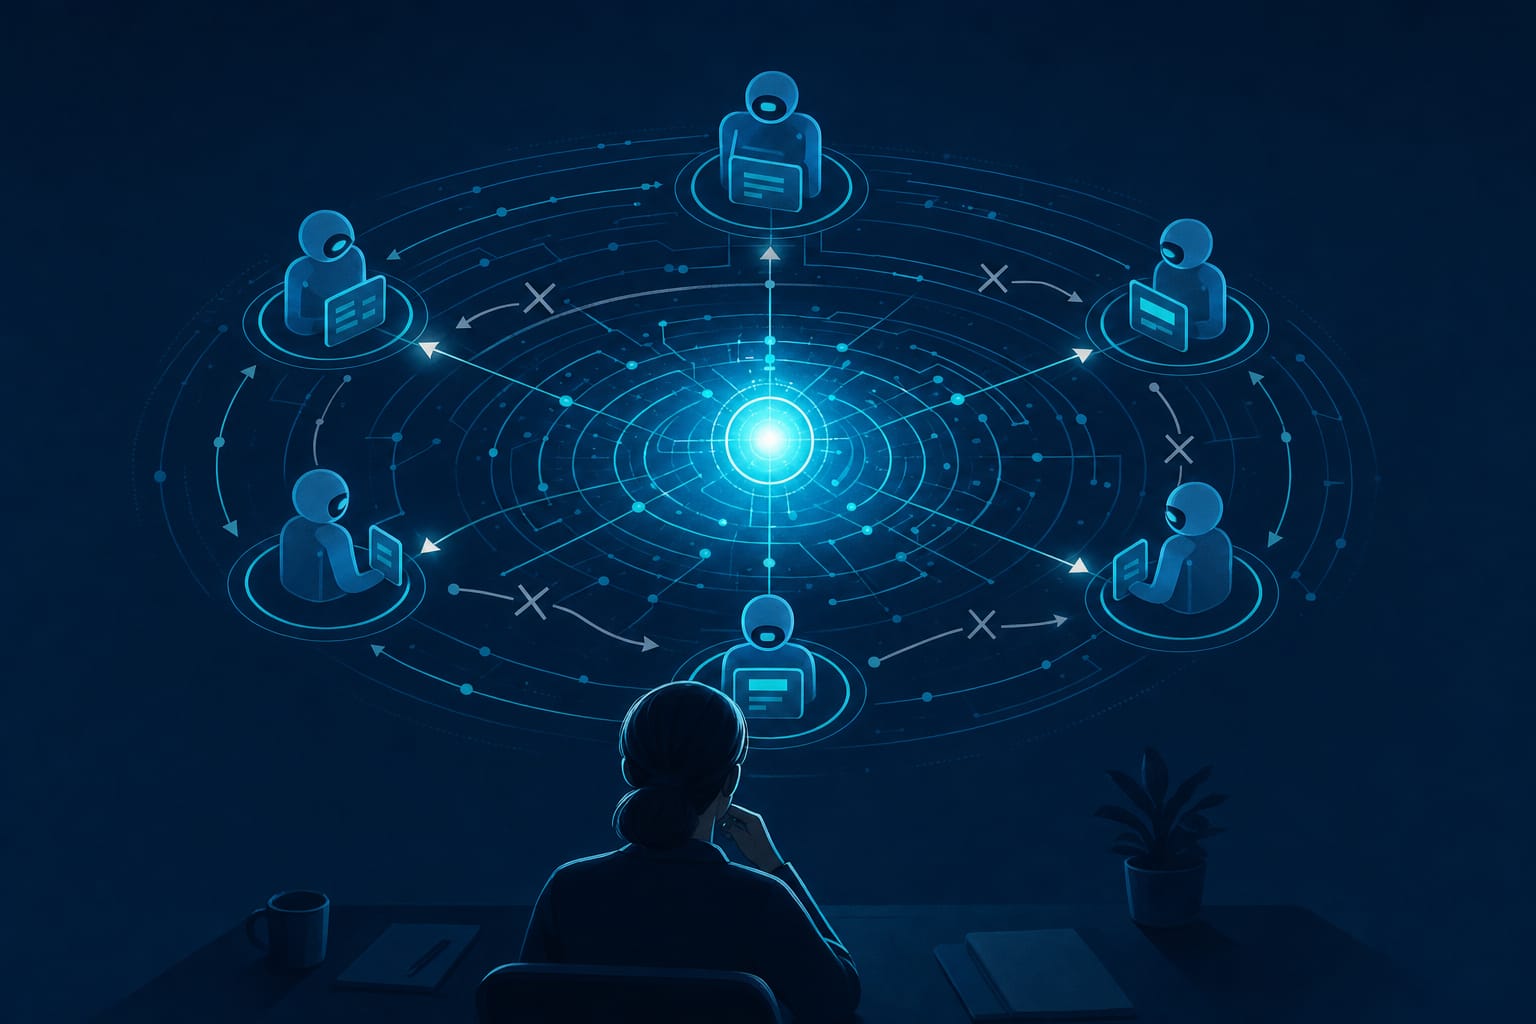
我的分工:一个做事,三个挑错,一个查资料
我现在的配置像一间小团队:
| 角色 | 由谁担任 | 我目前拿它做什么 |
|---|---|---|
| 执行者 | Claude Code | 写代码、改网站、整理文件,真正动手做事 |
| 挑错员 A | OpenAI Codex | 抓「平常没事、遇到特殊情况就静静出错」的问题,以及没算过就写下的数字 |
| 挑错员 B | xAI Grok | 抓「说涵盖全部、其实只做了一部分」的漏洞,也擅长判断后果有多严重 |
| 挑错员 C | Google Antigravity | 抓计划本身、整体方向的盲点 |
| 研究员 | Perplexity | 查网络上的最新资料,并附上原始出处 |
| 拍板的人 | 我 | 读完所有意见,决定采用哪些 |
这张表是这一轮的配置,不是各家的本质。模型一换,谁擅长抓什么就得重新记一次。
两条规则:三个挑错员只能读,不能改,一旦审查的人也能动手修,就没有人在审查了;没有任何一个 AI 做最后决定。怎么守住第二意见的独立、怎么把审查留下记录,我在之前两篇写过,这里不重复。
它看起来查过了:四种假象
分工做好之后,我以为剩下的事就是读报告。用了几个月,我发现读报告才是真正难的地方。挑错员交回来的东西,有四种固定的假象。
一、假的读文件
开头那件事,是 Antigravity 交出来的报告。它没有打开任何文件,却把我贴给它的内容标成「读文件」,还附上一个不存在的路径和数出来的行号。
换成一般人的情境,大概是你请 AI 帮你查一份报告的根据,它回你「根据某某研究第 12 页」,而那份研究根本不存在,或者存在但没有那一页。
我现在的追问是:它引用的东西,是我真的给过它的吗?不是的话,那一条只能当成推论,不能当成事实。
二、假的精确
AI 很擅长写出精确的数字,例如「影响 37 笔数据」。数字一精确,读的人就不会再问。
这一类还有一个变形。调用 Codex 时可以指定用比较强的模型来审查,但我遇过设置没有生效的情况(模型名称打错也会这样),它不会报错,而是安静地改用默认模型。报告看起来一样仔细,实际上是用基本款跑完的。所以我每次都会回头查记录,确认它实际用的是哪一个模型。
一般人的版本,大概是 AI 帮你写的企划书里出现「预估可节省 23% 成本」,你问它怎么算的,它给不出算式。
追问是:这个数字是从哪里算出来的?说不出来,这个数字就不能用。
三、假的会被发现
我回头检查过 Grok 的建议。它判断「后果多大」很准,但在我查的两次里,它都把「有留下记录」当成「出事时会被发现」。其中一次,它认为某个监控信号足以发现问题,但那个信号看的是程序有没有在跑,不是产出的东西是不是最新的。程序一直在跑,产出却已经过期,这个监控完全看不出来。
一般人的版本:「这件事会议记录有写,所以大家都知道。」会议记录有写,跟有人会去读,是两件事。
追问是:谁会去看那份记录?什么时候看?有记录不等于会被发现。
四、假的遵守
我刚开始设置 Grok 时测到过一次:限制它不能写文件,它被拒绝之后,改用另一种方式尝试写入。所以我替 Grok 叠了三层只读限制,一层被绕过,还有下一层。其他挑错员也一律设成只读。
一般人的版本:你叫它「只挑错,不要改我的文章」,它回你一份「建议修改版」,整篇都重写了。
追问是:我挡住的那条路,它有没有走别条?
这四种都是我个人用下来的记录,次数不多,不是什么跨用户的评比。但我相信换成任何一个 AI,都会有它自己的假象。差别只在你有没有把它们记下来。
一致不等于对
网络上讲多 AI 协作的文章,结尾通常是「大家都说没问题就可信,意见不同的地方再去看」。我原本也这样想。
后来读到一份研究让我改了看法。他们测了 350 多个模型,在其中一个数据集上,当两个模型都答错的时候,有六成的概率错成同一个答案;而且越大、越准的模型,就算架构不同、品牌不同,错得还是很像(Correlated Errors in Large Language Models,2025)。
所以我现在的读法是:意见分歧的地方,一定要自己去看;意见一致的地方,只代表它们没有分歧,不代表它们是对的。重要的决定,不管几个 AI 点头,还是要回到原始资料。
查资料的那一个,要注意什么
Perplexity 负责的工作不一样。它不审查我的东西,而是去网络上找答案:最新的价格、新闻、法规、某家公司的背景。它的好处是每个说法都附上原始网址,我可以点进去核对。
使用它有一条我一定遵守的规则:问它的每一句话,都当成会离开我的电脑。查询内容会送到外部的服务器,可能被保留,也可能拿去训练,所以客户名称、个人资料、金额、内部文件,一律不放进去。真的需要查,就改成不指名的问法,例如把「某某公司想导入某套系统」改成「中型制造业导入这类系统的常见做法」。
这件事跟 AI 无关,跟判断有关
我越用越觉得,多个 AI 协作真正改变的是判断的位置变得更清楚,速度倒是其次。以前一个 AI 给答案,我只能选择信或不信。现在有人做、有人挑错、有人查证,我的工作变成读懂它们为什么意见不同,再决定要相信哪一个。
这也提醒我一件事:AI 再多,最后签名负责的还是人。审查通过不等于批准,要不要发布、要不要部署、要不要寄出去,那一下还是要我自己按。
不写代码的人,也可以这样开始
你不需要装任何工具,也能用同样的逻辑:
- 用一个 AI 做事,另一个 AI 挑错。例如请 ChatGPT 写一份企划,再贴给 Claude 或 Gemini,请它「只指出问题,不要重写」。
- 读它的报告时,问那四句。它引用的东西你给过它吗?数字怎么算的?有记录的话谁会去看?你挡的路它有没有绕开?
- 两边意见不同时,自己回到原始资料看;两边意见相同时,重要的事也要看。这一步不能交给 AI。
如果想看更深入的做法,我写过如何让第二意见保持独立、如何把 AI 的查核留下可追溯的记录,以及在同一个界面操作多个 Agent 的完整流程。也可以从 AI 主题页 看这个系列的其他文章。
下次 AI 很有把握地告诉你一件事,先别急着问它「你确定吗」。换一个 AI 来问问看,然后,连那个 AI 的报告也一起怀疑。
💬 留言讨论
加载中...