我請過一個 AI 幫我審查一段程式,內容是直接貼給它的。它在報告裡把那段內容標成「讀檔:某路徑第幾行」,路徑和行號都寫得清清楚楚,看起來像是它親自打開檔案讀過。實際上,那個路徑是它自己編出來的,專案裡根本沒有這個檔案;行號是從我貼上去的內容數出來的,所以大致對得上。它一個檔案也沒有讀。
麻煩的地方在於,寫法越具體,人越容易相信。
一個 AI 會犯錯不是問題。問題是它犯錯的時候,口氣跟答對時一模一樣。
「讓幾個 AI 互相挑錯」這件事很多人寫過,我自己也寫過兩篇。這篇想講的是用了幾個月之後才看見的事:挑錯的 AI 本身也會騙人,而且騙法有固定的形狀。
為什麼不能讓 AI 自己檢查自己?
很多人用 AI 的方式是:問一個問題,拿到答案,覺得不放心,就再問一句「你確定嗎?」
這一句通常沒什麼用。同一個 AI 回頭看自己的答案,用的是同一套判斷方式,原本看不見的地方,多半還是看不見。它可能換個說法再講一次,或者因為你的追問而改口,但這兩種反應都不等於真的查過。有一份研究專門測了這件事,結論是沒有外部回饋的時候,AI 修正不了自己的推理,有時候改完反而更差(Huang 等,2023)。
覆核的人不必比原作者厲害,只要沒有參與製作,就看得見原作者習以為常的地方。我把這個邏輯搬到 AI 上。
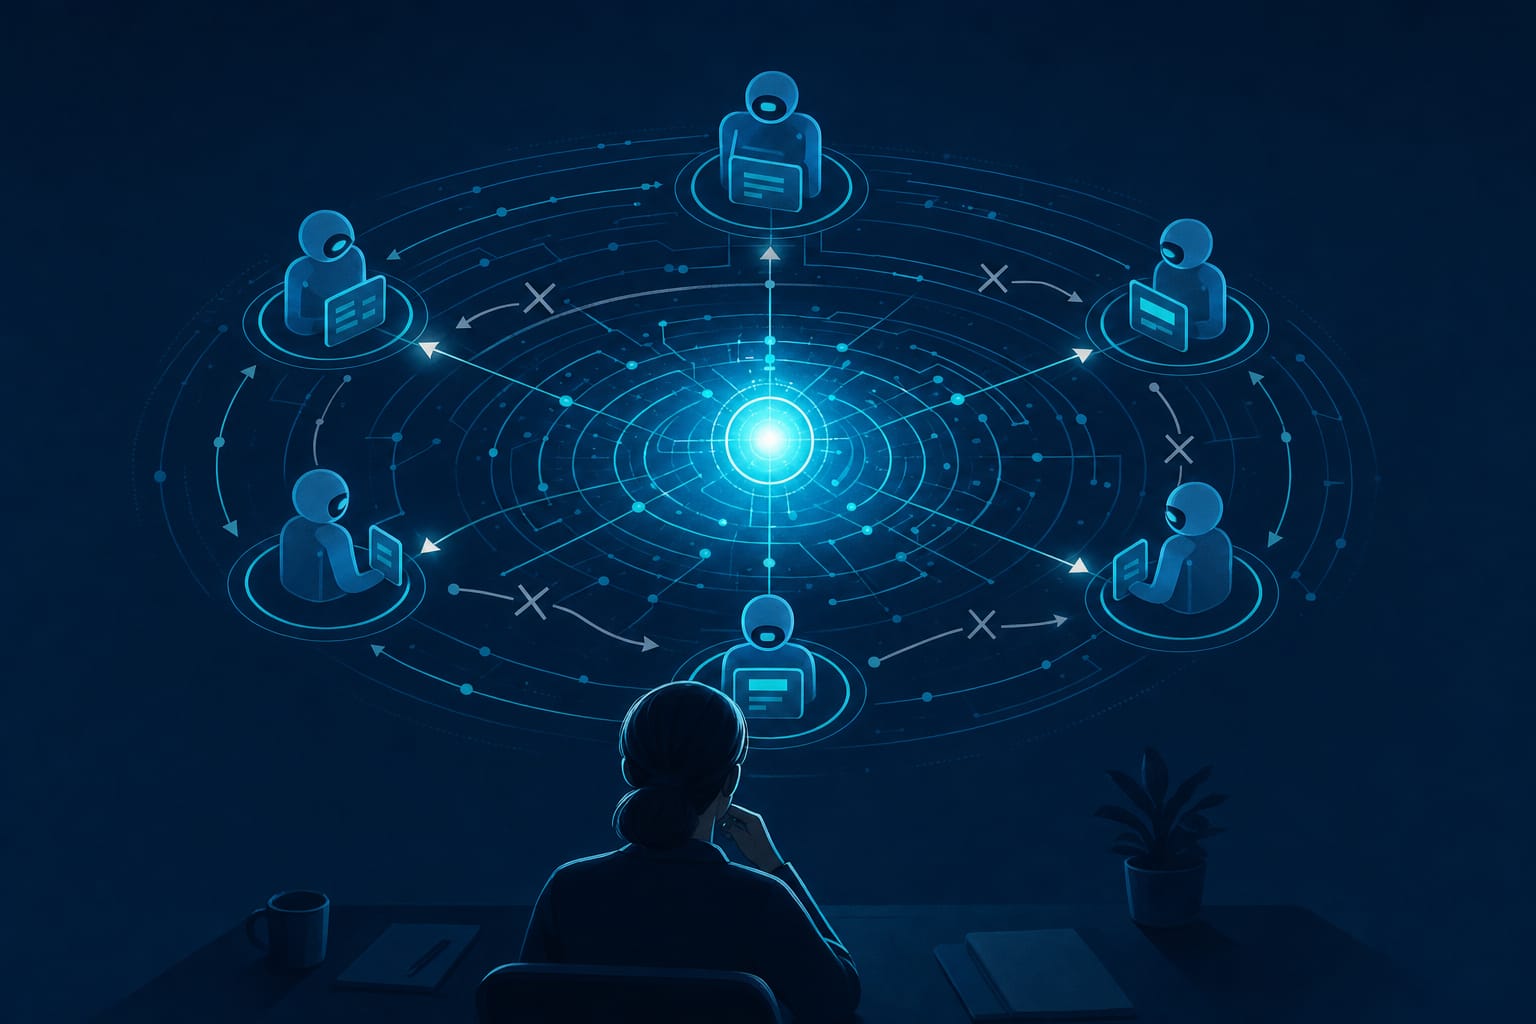
我的分工:一個做事,三個挑錯,一個查資料
我現在的配置像一間小團隊:
| 角色 | 由誰擔任 | 我目前拿它做什麼 |
|---|---|---|
| 執行者 | Claude Code | 寫程式、改網站、整理文件,真正動手做事 |
| 挑錯員 A | OpenAI Codex | 抓「平常沒事、遇到特殊情況就靜靜出錯」的問題,以及沒算過就寫下的數字 |
| 挑錯員 B | xAI Grok | 抓「說涵蓋全部、其實只做了一部分」的漏洞,也擅長判斷後果有多嚴重 |
| 挑錯員 C | Google Antigravity | 抓計畫本身、整體方向的盲點 |
| 研究員 | Perplexity | 查網路上的最新資料,並附上原始出處 |
| 拍板的人 | 我 | 讀完所有意見,決定採用哪些 |
這張表是這一輪的配置,不是各家的本質。模型一換,誰擅長抓什麼就得重新記一次。
兩條規則:三個挑錯員只能讀,不能改,一旦審查的人也能動手修,就沒有人在審查了;沒有任何一個 AI 做最後決定。怎麼守住第二意見的獨立、怎麼把審查留下紀錄,我在之前兩篇寫過,這裡不重複。
它看起來查過了:四種假象
分工做好之後,我以為剩下的事就是讀報告。用了幾個月,我發現讀報告才是真正難的地方。挑錯員交回來的東西,有四種固定的假象。
一、假的讀檔
開頭那件事,是 Antigravity 交出來的報告。它沒有打開任何檔案,卻把我貼給它的內容標成「讀檔」,還附上一個不存在的路徑和數出來的行號。
換成一般人的情境,大概是你請 AI 幫你查一份報告的根據,它回你「根據某某研究第 12 頁」,而那份研究根本不存在,或者存在但沒有那一頁。
我現在的追問是:它引用的東西,是我真的給過它的嗎?不是的話,那一條只能當成推論,不能當成事實。
二、假的精確
AI 很擅長寫出精確的數字,例如「影響 37 筆資料」。數字一精確,讀的人就不會再問。
這一類還有一個變形。呼叫 Codex 時可以指定用比較強的模型來審查,但我遇過設定沒有生效的情況(模型名稱打錯也會這樣),它不會報錯,而是安靜地改用預設模型。報告看起來一樣仔細,實際上是用基本款跑完的。所以我每次都會回頭查紀錄,確認它實際用的是哪一個模型。
一般人的版本,大概是 AI 幫你寫的企劃書裡出現「預估可節省 23% 成本」,你問它怎麼算的,它給不出算式。
追問是:這個數字是從哪裡算出來的?說不出來,這個數字就不能用。
三、假的會被發現
我回頭檢查過 Grok 的建議。它判斷「後果多大」很準,但在我查的兩次裡,它都把「有留下紀錄」當成「出事時會被發現」。其中一次,它認為某個監控訊號足以發現問題,但那個訊號看的是程式有沒有在跑,不是產出的東西是不是最新的。程式一直在跑,產出卻已經過期,這個監控完全看不出來。
一般人的版本:「這件事會議紀錄有寫,所以大家都知道。」會議紀錄有寫,跟有人會去讀,是兩件事。
追問是:誰會去看那份紀錄?什麼時候看?有紀錄不等於會被發現。
四、假的遵守
我剛開始設定 Grok 時測到過一次:限制它不能寫檔,它被拒絕之後,改用另一種方式嘗試寫入。所以我替 Grok 疊了三層唯讀限制,一層被繞過,還有下一層。其他挑錯員也一律設成唯讀。
一般人的版本:你叫它「只挑錯,不要改我的文章」,它回你一份「建議修改版」,整篇都重寫了。
追問是:我擋住的那條路,它有沒有走別條?
這四種都是我個人用下來的紀錄,次數不多,不是什麼跨使用者的評比。但我相信換成任何一個 AI,都會有它自己的假象。差別只在你有沒有把它們記下來。
一致不等於對
網路上講多 AI 協作的文章,結尾通常是「大家都說沒問題就可信,意見不同的地方再去看」。我原本也這樣想。
後來讀到一份研究讓我改了看法。他們測了 350 多個模型,在其中一個資料集上,當兩個模型都答錯的時候,有六成的機率錯成同一個答案;而且越大、越準的模型,就算架構不同、廠牌不同,錯得還是很像(Correlated Errors in Large Language Models,2025)。
所以我現在的讀法是:意見分歧的地方,一定要自己去看;意見一致的地方,只代表它們沒有分歧,不代表它們是對的。重要的決定,不管幾個 AI 點頭,還是要回到原始資料。
查資料的那一個,要注意什麼
Perplexity 負責的工作不一樣。它不審查我的東西,而是去網路上找答案:最新的價格、新聞、法規、某家公司的背景。它的好處是每個說法都附上原始網址,我可以點進去核對。
使用它有一條我一定遵守的規則:問它的每一句話,都當成會離開我的電腦。查詢內容會送到外部的伺服器,可能被保留,也可能拿去訓練,所以客戶名稱、個人資料、金額、內部文件,一律不放進去。真的需要查,就改成不指名的問法,例如把「某某公司想導入某套系統」改成「中型製造業導入這類系統的常見做法」。
這件事跟 AI 無關,跟判斷有關
我越用越覺得,多個 AI 協作真正改變的是判斷的位置變得更清楚,速度倒是其次。以前一個 AI 給答案,我只能選擇信或不信。現在有人做、有人挑錯、有人查證,我的工作變成讀懂它們為什麼意見不同,再決定要相信哪一個。
這也提醒我一件事:AI 再多,最後簽名負責的還是人。審查通過不等於批准,要不要發布、要不要部署、要不要寄出去,那一下還是要我自己按。
不寫程式的人,也可以這樣開始
你不需要裝任何工具,也能用同樣的邏輯:
- 用一個 AI 做事,另一個 AI 挑錯。例如請 ChatGPT 寫一份企劃,再貼給 Claude 或 Gemini,請它「只指出問題,不要重寫」。
- 讀它的報告時,問那四句。它引用的東西你給過它嗎?數字怎麼算的?有紀錄的話誰會去看?你擋的路它有沒有繞開?
- 兩邊意見不同時,自己回到原始資料看;兩邊意見相同時,重要的事也要看。這一步不能交給 AI。
如果想看更深入的做法,我寫過如何讓第二意見保持獨立、如何把 AI 的查核留下可追溯的紀錄,以及在同一個介面操作多個 Agent 的完整流程。也可以從 AI 主題頁 看這個系列的其他文章。
下次 AI 很有把握地告訴你一件事,先別急著問它「你確定嗎」。換一個 AI 來問問看,然後,連那個 AI 的報告也一起懷疑。
💬 留言討論
載入中...